PersianDB
یک موتور پایگاهداده که با Rust و CUDA نوشته شده و کوئری را از ابتدا تا انتها روی کارت گرافیک اجرا میکند
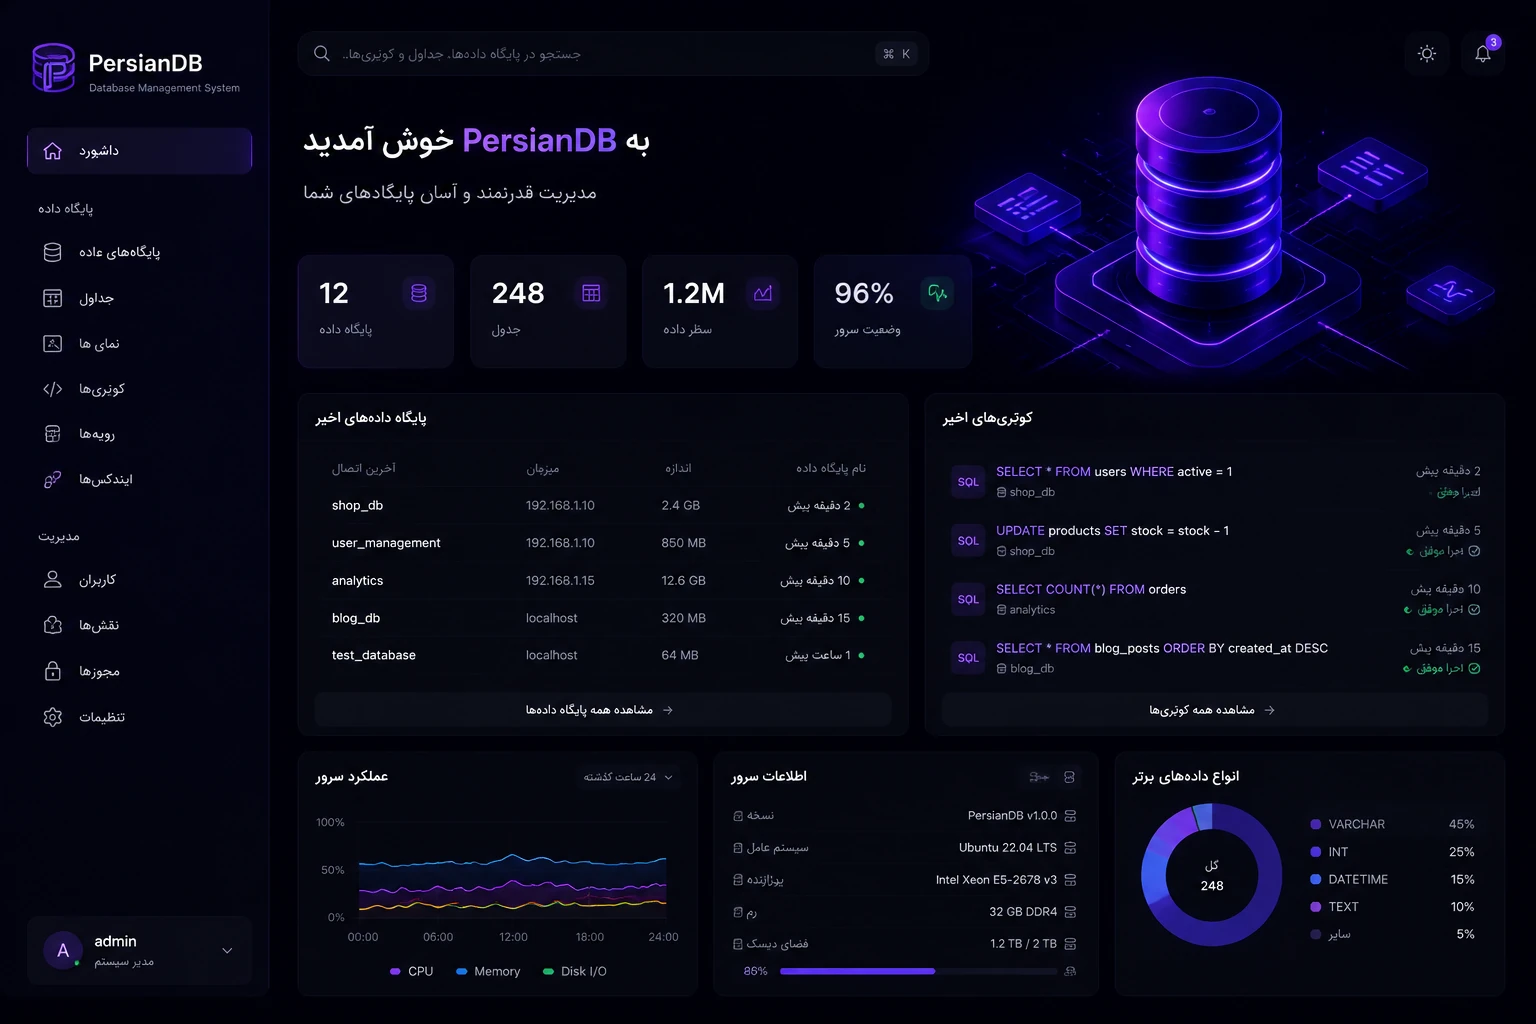
پایگاهدادهای که داده را روی کارت گرافیک نگه میدارد و همانجا هم به آن پاسخ میدهد، بدون اینکه اول به CPU برگرداندش.
چیست
بیشتر ابزارهای شتابگرفته با GPU داده را به کارت منتقل میکنند، محاسبه میکنند، و نتیجه را برمیگردانند. آن انتقال معمولاً تمام هزینه است.
PersianDB مسیر برعکس را میرود. ستونها بهصورت دائم در حافظه GPU زندگی میکنند، کوئریها آنجا بهصورت کرنل CUDA اجرا میشوند، و نتیجه بهشکل ردیف معمولی برمیگردد تا اپلیکیشن بتواند مصرفش کند. نکته «سریع است» نیست. نکته این است که داده هرگز کارت را ترک نمیکند — و همین است که اجرای یک بار کاری واقعی پایگاهداده روی GPU را ممکن میکند، نه فقط یک جاب کدشته.
چه کار میکند
- داده روی GPU زندگی میکند. چون هر ستون چیدمان و طول ثابت و معلومی دارد، CPU میتواند آدرسش را به GPU بدهد بدون اینکه حتی یک بایت کپی شود.
- کوئری واقعی است. فیلتر، projection، مرتبسازی و join — ۱۹ کرنل CUDA دستنویس — و همهچیز بین کوئریها resident میماند.
- حافظه را خودت انتخاب میکنی. یک آرنای سراسری مالک همه ستونهاست. چون آرنا ثابت و پیوسته است، آدرس هر ستون از قبل معلوم است؛ و همین چیزی است که ترفند «ماندن روی GPU» را اصلاً ممکن میکند.
- تغییر داده بدون توقف. فشردهسازی یک ستون در حال رشد فقط بایتهایی را کپی میکند که واقعاً جابهجا شدهاند — یک میلیون append یک میلیون رکورد جابهجا میکند، نه کل ستون را.
- نوشتن عمداً صادقانه است. insert و update از مسیر CPU میروند و کد هم این را میگوید بهجای اینکه وانمود کند بینقص است. این موتور برای سمت خواندن ساخته شده، جایی که حجم واقعی آنجاست.
اعداد
روی ماشین خودم اندازهگیری شده، از روی گزارش بنچمارک خود پروژه — نه نقل از جای دیگر:
| ۲٫۹۸ میلیارد | ردیف بر ثانیه، میانه — اسکن حجیم روی ۵ میلیون ردیف |
| ۱٫۶۸ میلیثانیه | زمان واقعی همان اسکن |
| ۳۰٫۵ میلیون | ردیف بر ثانیه insert پایدار |
| ۶۱٬۷۰۰ | خط Rust و CUDA |
| ۷۰۸ | تست خودکار، همه پاس |
با عدد اسکن حجیم با احتیاط برخورد کن، و دلیلش این است. ۲٫۹۸ میلیارد ردیف بر ثانیه شبیه ادعای سرعت کوئری به نظر میرسد، ولی نیست. این یک عدد توان عبوری برای خواندن ردیف است، و خواندن ردیف همان چیزی است که اندازهگیری پهنای باند حافظه در آن خوب است. بیان صادقانه همان چیزی است که در گزارش آمده: ۸۵٫۶٪ زمان اسکن صرف سربار همگامسازی میشود، نه حافظه. کوئری واقعی در مرتبه ۷۰۰ نانوثانیه به ازای هر ردیف تمام میشود.
فاصله بین «سه میلیارد ردیف بر ثانیه» و «۷۰۰ نانوثانیه بر ردیف» نقص در گزارشنویسی من نیست — وضعیت واقعی همین است، و خواننده حق دارد هر دو عدد را ببیند. نسخه قبلی این صفحه عددی را برای باینریای نقل میکرد که اصلاً وجود نداشت؛ آن عدد غلط بود و حذف شده.
چرا ارزش دیدن دارد
سه چیز در این پروژه واقعاً سخت و واقعاً قابل استفاده مجدد است:
حافظه قابل پیشبینی، وگرنه کل ایده فرو میریزد. رویکرد «نگهداشتن روی GPU» کاملاً به این وابسته است که آدرس یک ستون پیش از اجرای کوئری معلوم باشد. یعنی یک آرنای ثابت، بدون fragmentation، بدون reallocation. و یعنی یک سقف ظرفیت — که یک بدهبستان واقعی است، نه باگ.
چیدمان باینری پایدار، تا پایتون بتواند بدون کپی از آن استفاده کند. کل موتور را با PyO3 به پایتون دادم، و این فقط وقتی ممکن است که چیدمان حافظه تعریف و منجمد شده باشد. همین قید است که رابط را ممکن میکند — رابط چیدمان را تحمیل کرد، نه برعکس.
باگهایی که فقط با نگاه کردن پیدا میشوند. جالبترین باگ این پروژه توکنایزری بود که شمارش را در یک نوع
اعشار شناور غیرشرکتپذیر جمع میکرد. هر تقسیم واکبورد بهتنهایی ریاضی درست بود، ولی چون جمع اعشار شناور گروهبندی
را جابهجا نمیکند، vocab_size بین دو اجرا روی همان فایل فرق میکرد. هیچچیز کرش نکرد. فقط اعداد بازتولید
نبودند. پیدا کردن این دسته چیزها، بیشترِ کارِ مهندسی است.
وضعیت فعلی
صریح مینویسم، چون رزومهای که این را پنهان کند ارزش خواندن ندارد:
- خواندن حجیم و فیلتر کار میکند و بنچمارک شده است.
UPDATEوDELETEفعلاً بدون تغییر چیزی موفقیت برمیگردانند. پیادهسازی نشدهاند. این مهمترین نکته درباره این پروژه است.- مسیر ستونی نوشته نمیشود. موتور هنوز سیستم مرجع هیچ چیزی نیست.
- بنچمارکها مخصوص همین ماشیناند. روی یک GPU اجرا شدهاند و روی سیستم شما تکرار نمیشوند.
یک درخواست ثبت اختراع برای معماری اجرای GPU-resident وجود دارد — در حال حاضر در مرحله داوری.